Samsungin LittleBit kutistaa 13 miljardin parametrin kielimallin alle gigatavuun
Samsung Researchin LittleBit kutistaa 13 miljardin parametrin Llama2-mallin alle 0,9 gigatavuun eli noin 31 kertaa pienempään tilaan kuin alkuperäinen malli.
Samsung Researchin tutkijat ovat kehittäneet LittleBit-nimisen menetelmän, joka kutistaa suuret kielimallit murto-osaan entisestä koostaan. Menetelmä painaa 13 miljardin parametrin Llama2-mallin alle 0,9 gigatavuun, kun alkuperäinen malli veisi yli 26 gigatavua. Tutkimus hyväksyttiin NeurIPS 2025 -konferenssiin, ja menetelmän koodi on avoimesti saatavilla GitHubissa. Aihe on noussut esille myös sosiaalisessa mediassa jaetussa tiivistyksessä.
Mitä kvantisointi tarkoittaa?
Kielimallin osaaminen on tallentunut sen parametreihin eli lukuihin, jotka ovat opettelun aikana säätyneet. Mallin kutistamista sanotaan kvantisoinniksi: siinä mallin lukuja tallennetaan epätarkemmassa muodossa, jolloin ne vievät vähemmän tilaa. Tavallisin tarkkuus on ollut 4 bittiä kutakin lukua kohden, ja alle yhden bitin tarkkuutta on pidetty vaikeana rajana, koska tiedon menetys kasvaa siellä nopeasti ja mallin laatu romahtaa helposti. Tarkkuutta mitataan bittiä painoa kohden (bits per weight, BPW). LittleBit yltää 0,1 bittiin painoa kohden eli kymmenesosaan yhdestä bitistä.
Näin LittleBit puristaa mallin
LittleBit ei yritä tallentaa mallin painoja sellaisenaan. Se jakaa jokaisen painomatriisin ensin kahdeksi pienemmäksi matriisiksi eli niin sanotuiksi latenttikertoimiksi ja muuttaa ne sen jälkeen yksinkertaisiksi plus- ja miinusmerkeiksi. Tällaista pelkistämistä kahteen merkkiin kutsutaan binarisoinniksi.
Pelkkä merkkien tallentaminen hävittäisi kuitenkin liikaa tietoa, joten menetelmä palauttaa suuruusluokan kolmella opetettavalla skaalauskertoimella: yksi kertoimista kertoo rivien, toinen sarakkeiden ja kolmas latenttiulottuvuuksien tärkeyden. Tämän monitasoisen korjauksen ansiosta malli pysyy käyttökelpoisena hyvin pienestä koostaan huolimatta.
Koulutuksen vakaus on ratkaistu kahdella keinolla. Dual-SVID-alustus antaa koulutukselle hyvän lähtökohdan, ja jäännöskorjaus eli residuaalikorjaus paikkaa sitä virhettä, joka syntyy alkuperäisen matriisin ja sen kutistetun version erotuksesta. Lisäksi rakenne korvaa raskaan desimaalilukujen kertolaskun kevyemmillä, binäärisillä laskutoimituksilla.
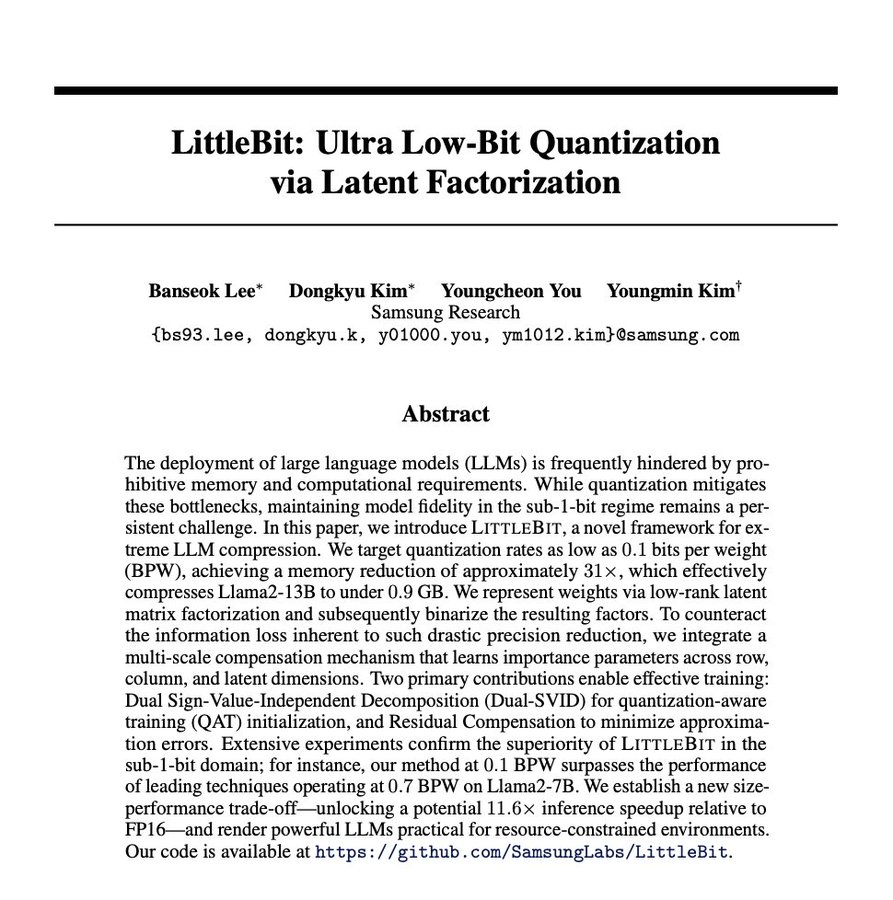
Kuvakaappaus tutkimuspaperista
Alla on kuvakaappaus LittleBit-tutkimuspaperin alusta. Siitä näkyvät tutkimuksen otsikko, tekijät Samsung Researchilta sekä tiivistelmä, johon menetelmän keskeiset tulokset on koottu.
Tulokset: muisti kutistuu monikymmenkertaisesti
Samsungin mukaan LittleBit pienentää mallien muistintarvetta rajusti. Llama2-13B vie tavallisessa 16 bitin tarkkuudessa 26,06 gigatavua, mutta LittleBitillä 0,1 BPW:n tarkkuudella enää 0,84 gigatavua, eli noin 31 kertaa vähemmän. Llama2-7B kutistuu 0,63 gigatavuun ja Llama2-70B 1,98 gigatavuun, kun alkuperäinen 70 miljardin parametrin malli veisi yli 138 gigatavua. Kyseessä on lähes 70-kertainen muistinsäästö.
Koko ei ole kasvanut laadun kustannuksella. Kielimallien laatua mitataan yleisesti hämmennyksellä eli perplexityllä, jossa pienempi luku on parempi. Samsungin mukaan LittleBit yltää Llama2-7B-mallissa 0,1 BPW:n tarkkuudella hämmennykseen 15,92, mikä on parempi kuin aiemman kärkimenetelmän tulos 19,17 sen käyttäessä seitsemän kertaa suurempaa tarkkuutta 0,7 BPW. Myös päättelytehtävissä LittleBit säilyttää osaamisensa tarkkuuksilla, joilla aiemmat menetelmät romahtavat.
Nopeus paranee samalla. Samsungin mittauksissa LittleBitin laskentaydin oli 11,6 kertaa nopeampi kuin tavallinen 16 bitin laskenta Nvidian A100-näytönohjaimella. Koko mallin tasolla Llama2-7B tuotti 0,1 BPW:n tarkkuudella 203,20 tokenia sekunnissa, kun tavallinen 16 bitin versio ylsi 82,56 tokeniin sekunnissa.
Menetelmä tuo mukanaan myös ylimääräisen edun. Koska mallin rakenne on jaettu kertoimiin, malli tarvitsee keskustelun aikana muistiin aiempaa pienemmän välitilan eli KV-välimuistin. Samsungin arvion mukaan Llama2-7B:n välimuisti pienenee 0,1 BPW:n tarkkuudella noin 21-kertaisesti.
Mitä sosiaalisessa mediassa kerrotaan?
Aiheesta on levinnyt X:ssä tiivistys, jossa menetelmän kerrotaan kutistavan 13 miljardin parametrin kielimallin alle gigatavuun. Tiivistyksen mukaan malli ei enää tallenna painoja tavallisina lukuina, vaan hyödyntää latenttikertoimia ja yltää pahimmillaan 0,1 bittiin painoa kohden.
Tiivistys nostaa esiin myös laskennan muutoksen: kun malli on puristettu näin pieneksi, raskas desimaalilukujen kertolasku voidaan korvata yksinkertaisella merkkien vaihdolla eli käytännössä bittitason operaatiolla. Samat kohdat toistuvat Samsungin omassa tutkimuksessa, jossa mainitaan 11,6-kertainen nopeutus ja se, että menetelmä pysyy vakaana myös alle 0,5 bitin tarkkuuksilla, joilla aiemmat menetelmät epäonnistuvat. Tiivistyksen johtopäätös on, että kyse on mahdollisuudesta ajaa suuria kielimalleja paikallisesti edullisilla laitteilla.
Mitä tästä seuraa?
LittleBit on suunnattu erityisesti reunalaskentaan eli tilanteisiin, joissa malli ajetaan käyttäjän omalla laitteella palvelinkeskuksen sijaan. Jos suuri malli mahtuu alle kahden gigatavun muistiin, se voisi sopia esimerkiksi kannettaviin tietokoneisiin, puhelimiin ja muihin laitteisiin, joissa muisti on vähissä ja verkkoyhteyttä ei haluta käyttää.
Menetelmän koodi on saatavilla GitHubissa, ja se tukee muun muassa Llama-, Qwen-, Gemma- ja Phi-4-malliperheitä. Lisenssi on CC BY-NC 4.0, joka sallii käytön ei-kaupallisesti. Tutkimusta on jo jatkettu: LittleBit-2-niminen jatkokehitys hyväksyttiin ICML 2026 -konferenssiin, ja se parantaa erityisesti koulutuksen alkuvaihetta. Kyse on toistaiseksi tutkimustyöstä, joten tulokset on mitattu tutkimuspaperin testeillä, eivät valmiissa kuluttajatuotteissa.
Lähteet
- Banseok Lee, Dongkyu Kim, Youngcheon You, Youngmin Kim (Samsung Research): LittleBit: Ultra Low-Bit Quantization via Latent Factorization (arXiv:2506.13771, NeurIPS 2025)
- Samsung Research: LittleBit: Ultra Low-Bit Quantization via Latent Factorization (blogikirjoitus)
- GitHub: SamsungLabs/LittleBit (lähdekoodi ja dokumentaatio)
- X: Superman (@thesupermannx) (sosiaalisen median tiivistys)
Vastuuvapauslauseke: Tämä artikkeli on tarkoitettu vain tiedotustarkoituksiin. Sitä ei tarjota tai ole tarkoitettu käytettäväksi oikeudellisena, verotuksellisena, sijoitus-, rahoitus- tai muuna neuvona.
Mainos: alla on kumppanimainoksia ja mainoslinkkejä.