Scraping ja oma verkkosivu: miten estät tekoälybotit
Tekoälybotit kopioivat sivujesi sisältöä opetukseen ja vastauksiin. Opas näyttää askel askeleelta, miten estät ei-toivotun kaavinnan robots.txt-tiedostolla, Content-Signal-rivillä ja teknisillä estoilla.
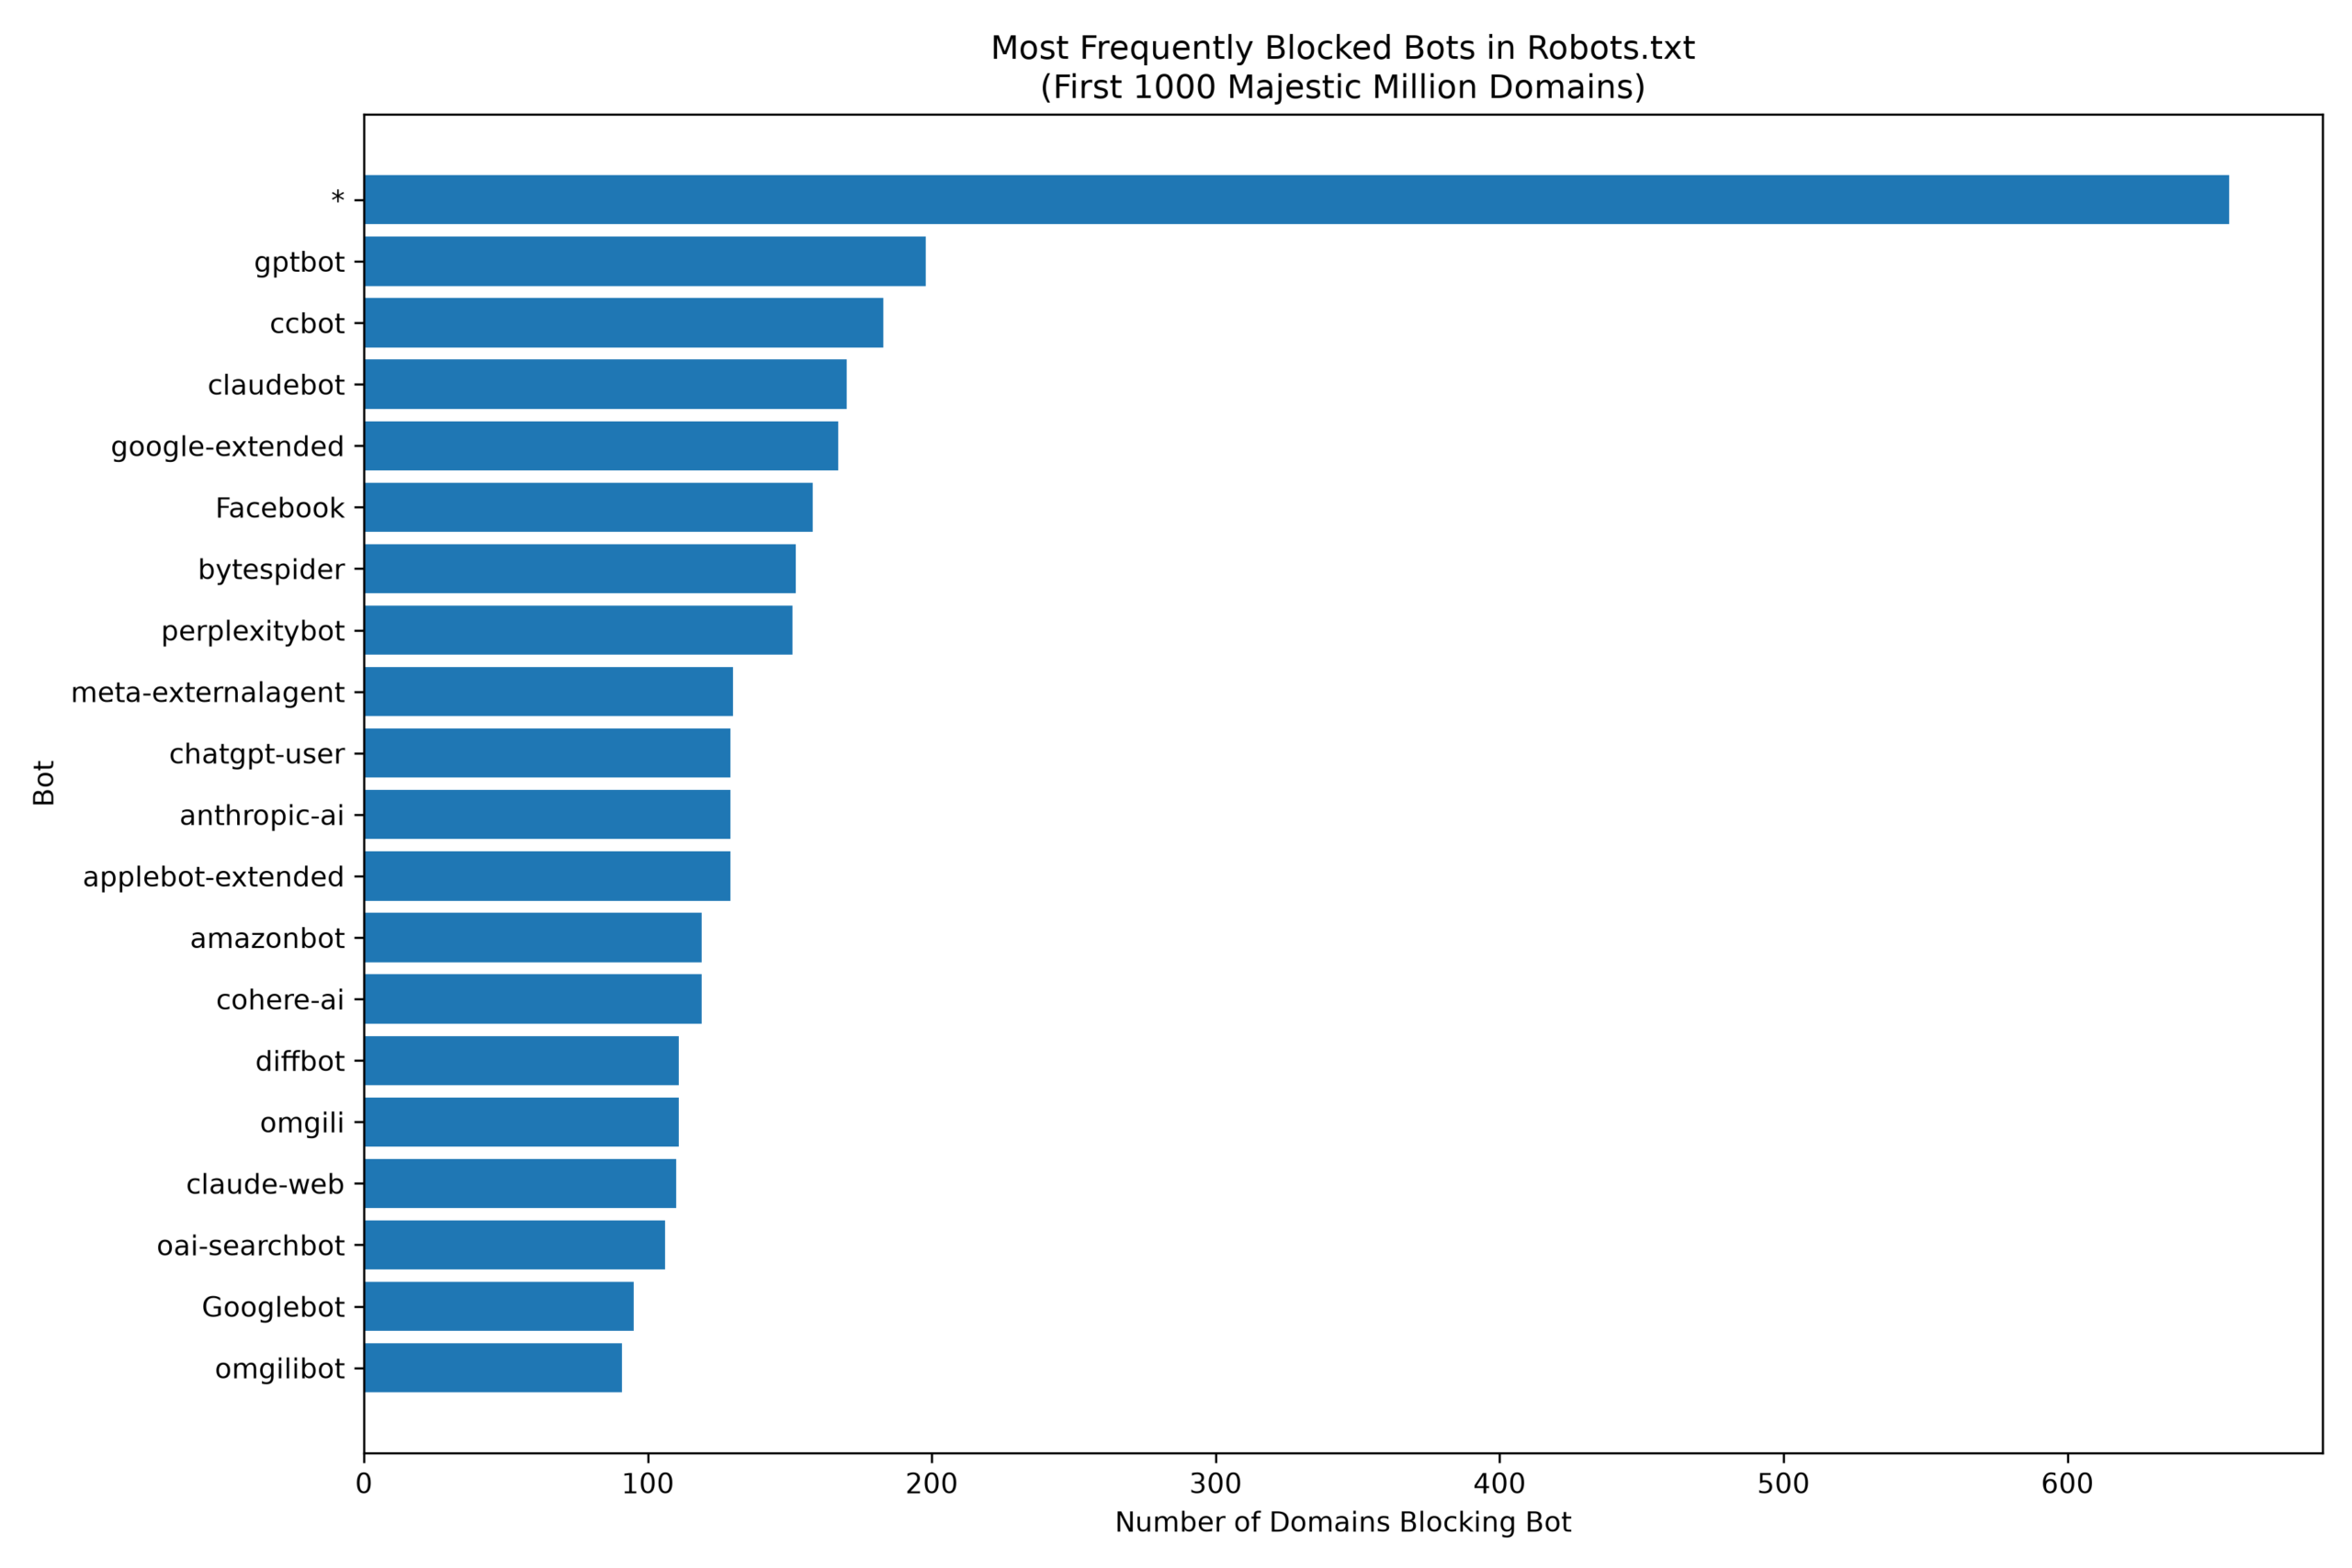
Kaavio: useimmin estetyt botit robots.txt-tiedostoissa kesäkuussa 2026. Aineisto: 1 000 verkkotunnusta Majestic Million -listalta. Kuva: ChippyTimeCom, CC BY-SA 4.0, Wikimedia Commons.
Tekoälybotit käyvät sivullasi myös silloin, kun kukaan ihminen ei ole paikalla. Ne kopioivat tekstiä kielimallien opetusaineistoksi, rakentavat hakemistoja ja hakevat sisältöä vastauksiin, joita ihmiset kysyvät chatista. Tämä opas näyttää, miten verkkosivun omistaja voi estää ei-toivotun kaavinnan. Opas etenee työjärjestyksessä: ensin päätät, mitä haluat estää, sitten kirjoitat robots.txt-tiedoston, sen jälkeen otat käyttöön tehokkaamman eston ja lopuksi tarkistat, ettei mikään mennyt rikki. Mallit ovat tavallista tekstiä, jonka voi kopioida sellaisenaan.
Mitä verkkokaavinta tarkoittaa ja miksi se koskee pientäkin sivustoa
Verkkokaavinta tarkoittaa sitä, että ohjelma lukee verkkosivun sisällön ja tallentaa sen itselleen. Sana tulee englannin verbistä to scrape, joka tarkoittaa kaapimista. Kaapija ei katsele sivua silmillään vaan poimii sivun tekstin, kuvien osoitteet ja rakenteen koneellisesti. Yksi botin käynti voi hakea kymmeniä sivuja sekunnissa.
Kaikki kaavinta ei ole vahingollista. Hakukoneet tekevät periaatteessa samaa työtä, ja niiden ansiosta sivusi löytyy hausta. Ero on siinä, mitä sisällöllä tehdään sen jälkeen. Hakukone lähettää lukijan sivullesi. Opetusaineistoksi menevä kopio ei lähetä ketään: se uppoaa mallin painoihin, eikä alkuperäistä tekijää yleensä mainita millään tavalla.
Pienelle sivustolle kolme asiaa tekee asiasta merkityksellisen. Palvelin kuormittuu, kun botti imee satoja sivuja. Sisältöön on käytetty työtä, mutta siitä ei saa mitään vastineeksi. Ja kun tekoälyhaku vastaa kysymykseen suoraan tulossivulla, lukija ei enää tulekaan sivullesi asti. Siksi ratkaisu ei ole “estä kaikki” vaan “estä se, mikä ei tuo mitään takaisin”.
Kolme käyttötarkoitusta: päätä ensin, mitä haluat estää
Tekoälybotit eivät ole yksi joukko. Cloudflare jakoi vuonna 2026 botit kolmeen käyttötarkoitukseen, ja saman jaon ovat tehneet myös OpenAI ja Anthropic omissa robots.txt-ohjeissaan. Jako on hyödyllinen, koska se pakottaa miettimään, mitä estolta haluaa.
| Käyttötarkoitus | Mitä botti tekee | Esimerkkejä boteista | Mitä estäminen tarkoittaa |
|---|---|---|---|
| Haku | Kerää ja indeksoi sivusi, jotta voi vastata myöhemmin esitettyihin kysymyksiin. | OAI-SearchBot, Claude-SearchBot, PerplexityBot | Sivusi ei enää näy tekoälyhaun vastauksissa eikä lainauksissa. |
| Agentti | Toimii ihmisen puolesta juuri nyt: avaa sivun ja tekee pyydetyn asian. | ChatGPT-User, Claude-User | ChatGPT tai Claude ei voi avata sivuasi, kun käyttäjä pyytää sitä. |
| Koulutus | Kopioi sisällön mallin opetukseen tai hienosäätöön. | GPTBot, ClaudeBot, Google-Extended, CCBot, Bytespider, meta-externalagent, Applebot-Extended | Sisältöäsi ei pitäisi käyttää uusien mallien opetukseen. |
Jokainen botti on oma kohteensa. OpenAI kertoo ohjeissaan, että GPTBotin esto ei estä OAI-SearchBotia eikä ChatGPT-Useria, ja Anthropic sanoo saman kolmesta omasta botistaan. Tekoälyagentti on siis syytä erottaa koulutusbotista: agentti vastaa ihmisen juuri tekemään pyyntöön, koulutusbotti kerää koulutusdataa tulevaisuutta varten.
Googlella on oma erikoisuutensa. Google-Extended ei ole erillinen crawler vaan pelkkä robots.txt-tunniste, jolla estetään sisällön käyttö Gemini-mallien opetuksessa ja vastausten pohjustuksessa. Google kertoo itse, ettei se vaikuta sivun näkymiseen Google-haussa eikä toimi sijoitussignaalina. Googlebotin estäminen sen sijaan vaikuttaa – ja se on yleisin vahinko, joka näissä säännöissä syntyy.
robots.txt on halvin ja nopein ensimmäinen askel
robots.txt sijaitsee verkkotunnuksen juuressa: https://omaverkkosivu.fi/robots.txt. Siinä sivuston omistaja kertoo automaattisille ohjelmille, mitä sivuston osia ne saavat lukea. Tiedosto on puhdasta tekstiä, ja jokainen rivi on yksi sääntö. Kommenteissa käytetään risuaitaa.
Käytännössä koko tiedosto koostuu ryhmistä. Ryhmä alkaa User-agent-rivillä ja jatkuu niin kauan, kunnes tulee tyhjä rivi tai uusi User-agent-rivi. Yhdellä rivillä voi olla vain yksi sääntö. Tähti tarkoittaa kaikkia botteja, ja Disallow: / tarkoittaa koko sivustoa. Lopussa oleva kauttaviiva tarkoittaa kansiota: Disallow: /blogi/ estää blogin mutta ei osoitetta /blogi.
Tässä on malli, joka sopii useimmille sisältösivustoille. Hakukoneet ja tekoälyhaku saavat tulla, koulutusbotit eivät:
# Sallitaan haku, estetään koulutus
User-agent: *
Allow: /

User-agent: GPTBot
Disallow: /

User-agent: ClaudeBot
Disallow: /

User-agent: Google-Extended
Disallow: /

User-agent: CCBot
Disallow: /

User-agent: Bytespider
Disallow: /

User-agent: meta-externalagent
Disallow: /

User-agent: Applebot-Extended
Disallow: /

Sitemap: https://omaverkkosivu.fi/sitemap.xml
Jos haluat estää myös tekoälyhaun, lisää samaan tapaan omat ryhmät boteille OAI-SearchBot, Claude-SearchBot ja PerplexityBot. Muista, että se vähentää näkyvyyttäsi: ChatGPT ei silloin näytä sivujasi vastauksissaan. Jos haluat pitää tavalliset hakukoneet varmasti mukana, kirjoita niille oma salliva ryhmä ennen estäviä ryhmiä. Näin teet, kun haluat estää kaiken automaation paitsi haun:
User-agent: Googlebot
Allow: /

User-agent: Bingbot
Allow: /

User-agent: GPTBot
Disallow: /

User-agent: ClaudeBot
Disallow: /

User-agent: CCBot
Disallow: /

User-agent: *
Disallow: /
Yksi varoitus: Disallow: / rivin User-agent: * -ryhmässä estää myös Googlebotin, jos Googlebotille ei ole omaa ryhmää. Se on yleisin syy siihen, miksi sivusto katoaa hakukoneista yhdessä yössä.
robots.txt ei ole tekninen este. Cloudflare kirjoittaa omassa ohjeessaan suoraan, että tiedoston noudattaminen on vapaaehtoista: se ilmaisee toiveen, mutta ei estä pääsyä. Osa botin ylläpitäjistä voi jättää säännöt huomiotta. Tiedosto on silti hyödyllinen, koska suurimmat toimijat noudattavat sitä ja koska se toimii näyttönä tahdosta, jos asiaa joskus selvitetään.
robots.txt kannattaa tarkistaa itse. Kirjoita tiedoston osoite selaimen osoiteriville – tiedoston pitää aueta tavallisena tekstinä. Komentorivillä se onnistuu näin:
curl -sI https://omaverkkosivu.fi/robots.txtVastauksessa pitää näkyä 200 ja sisältötyyppi text/plain. Jos palvelin palauttaa 404, botit tulkitsevat, ettei rajoituksia ole. Jos palvelin palauttaa 500-alkuisen virheen, botit tulkitsevat RFC 9309 -standardin mukaan, että kaikki on kielletty – se pysäyttää myös hakukoneet. Botit voivat lisäksi käyttää välimuistissa olevaa kopiota jopa vuorokauden, joten muutos ei näy heti. OpenAI arvioi oman hakukanavansa osalta noin vuorokauden viivettä.
Älä luota Crawl-delay-riviin. Se ei ole standardi: Google ei tue sitä lainkaan, ja Anthropic kertoo tukevansa sitä omalla botillaan. Hidastuskeinona se on siis epävarma, vaikka siitä ei yleensä haittaa olekaan.
Content-Signal ja oikeuksien pidättäminen: kerro muustakin kuin pääsystä
robots.txt kertoo, kuka saa tulla. Se ei kerro, mitä sisällöllä saa tehdä sen jälkeen, kun se on haettu. Tähän tarpeeseen Cloudflare julkaisi vuonna 2026 Content Signals -käytännön, joka kirjoitetaan robots.txt-tiedostoon kommentteina ja yhtenä koneellisesti luettavana rivinä.
User-agent: *
Content-Signal: search=yes, ai-input=no, ai-train=no
Allow: /
Kolme signaalia tarkoittavat seuraavaa. search on hakemiston rakentamista ja hakutulosten näyttämistä. ai-input on sisällön syöttämistä malliin vastaushetkellä esimerkiksi tekoälyhaun vastausta varten. ai-train on mallin opettamista tai hienosäätöä. Jos signaalin jättää pois, se ei tarkoita kieltoa vaan sitä, ettei kantaa ole ilmaistu.
Tässä on tärkeä oikeudellinen ulottuvuus, ja se on hyvä ymmärtää. EU:n tekijänoikeusdirektiivin 4 artikla sallii tekstin ja tiedonlouhinnan laillisesti saatavilla olevasta aineistosta, mutta 3 kohdan mukaan poikkeus ei päde, jos oikeudenhaltija on nimenomaisesti pidättänyt oikeuden asianmukaisella tavalla – esimerkiksi verkkosisällössä koneellisesti luettavalla tavalla. Suomessa sama sääntö on tekijänoikeuslain 13 b §:ssä. Cloudflaren oma käytäntö sanoo suoraan, että sen signaaleilla ilmaistut rajoitukset ovat tällainen nimenomainen oikeuksien pidättäminen.
Käytännössä tämä tarkoittaa, että Content-Signal-rivi ei estä mitään, mutta se voi muuttaa oikeudellisen aseman. Tekstin- ja tiedonlouhinta ei ole silloin enää sallittua pelkän lain nojalla. Jos haluat vedota tähän myöhemmin, kirjaa muistiin, milloin rivi lisättiin ja miltä tiedosto näytti. Tekijänoikeus ei kuitenkaan anna nopeaa apua: riidan selvittäminen vaatii asianajajan, ja vahingon osoittaminen on vaikeaa. Siksi tekninen esto on käytännössä tehokkaampi kuin oikeudellinen.
Samassa yhteydessä törmää usein llms.txt-tiedostoon. Se on eri asia: se on ehdotus, jossa sivusto tarjoaa agenteille siistin markdown-muotoisen kartan sisällöstään. Se ei estä mitään eikä ole lupamekanismi. Se kannattaa nähdä kutsuna sisään, ei porttina.
Tekninen esto: kun pelkkä tiedosto ei riitä
Jos haluat, että esto pitää, se pitää tehdä pyynnön tasolla. Silloin botti ei saa sisältöä lainkaan, riippumatta siitä, mitä se lupaa noudattaa.
Ensimmäinen askel on tunnistaa, kuka käy. Palvelimen lokista näkyvät käyttäjäagentti eli se merkkijono, jolla ohjelma esittäytyy, sekä IP-osoite. Pelkkä käyttäjäagentti ei riitä tunnistukseen, koska kuka tahansa voi esittäytyä millä tahansa merkkijonolla. Suuret toimijat julkaisevat omat IP-avaruutensa: OpenAI osoitteessa openai.com/gptbot.json, Anthropic osoitteessa claude.com/crawling/bots.json ja Google omassa common-crawlers.json-tiedostossaan. Googlebotin voi varmistaa myös käänteisellä nimipalvelulla: oikea osoite päättyy googlebot.com-verkkotunnukseen.
Toinen askel on estää CDN:ssä tai palomuurissa. Cloudflarella on AI Crawl Control, jolla voi estää valittuja botteja, ja lisäksi mahdollisuus hallita kolmea luokkaa erikseen: Search, Agent ja Training. Kun estävä politiikka on käytössä, Cloudflare lisää robots.txt-tiedostoon kahdeksan tunnetun koulutusbotin estot: Amazonbot, Applebot-Extended, Bytespider, CCBot, ClaudeBot, Google-Extended, GPTBot ja meta-externalagent.
Tässä on yksi tuore ansa, joka kannattaa tuntea. Cloudflare kertoi heinäkuussa 2026, että 15. syyskuuta 2026 alkaen uusilla verkkotunnuksilla estetään oletuksena Training- ja Agent-luokat mainoksia näyttävillä sivuilla, kun taas Search sallitaan. Samalla monikäyttöiset crawlerit – Googlebot, Applebot ja BingBot – estetään sen mukaan, mitä kaikkia käyttötarkoituksia ne palvelevat. Käytännössä Training-eston valinnut asiakas voi huomata estäneensä myös Googlebotin. Oletuksen voi myös kumota, mutta se pitää tehdä tietoisesti.
Ilman CDN:ää eston voi tehdä myös palvelimen asetuksissa. Esimerkiksi nginx-palvelimella käyttäjäagentin voi poimia muuttujaan ja palauttaa estetyille boteille 403-vastauksen. Yksinkertainen sääntö riittää usein (muuttujan määrittely kuuluu http-tasolle):
map $http_user_agent $ai_bot {
    default 0;
    ~*GPTBot 1;
    ~*ClaudeBot 1;
    ~*CCBot 1;
}

if ($ai_bot) {
    return 403;
}
Kolmas askel on rajoittaa tahtia. Pyyntöjen määrän rajoitus ja yksinkertainen JavaScript-haaste pysäyttävät halvat skriptit, mutta eivät työkalua, joka ajaa oikeaa selainta. Ne kannattaa mitoittaa niin, ettei tavallinen lukija joudu odottamaan. Varmista lisäksi, ettei esto osu hakukoneisiin, mainosten tarkistajiin tai saavutettavuustyökaluihin.
Neljäs vaihtoehto on laskuttaa. Cloudflaren Pay Per Crawl -mallissa sisältö luovutetaan, kun botti maksaa pyynnöstä. Ilman maksua palvelin vastaa koodilla 402 Payment Required. Tämä sopii julkaisijalle, joka haluaa pitää ovet auki mutta ei ilmaiseksi. Pienelle sivustolle se on harvoin realistinen tulonlähde, mutta se on hyvä tuntea vaihtoehtona.
Yksi varoitus vielä: älä estä pelkän IP-osoitteen perusteella silloin, kun haluat botin noudattavan robots.txt-tiedostoa. Anthropic huomauttaa ohjeessaan, että IP-esto voi estää bottia lukemasta robots.txt-tiedostoa, jolloin opt-out ei rekisteröidy lainkaan.
Yleisimmät virheet ja tarkistuslista
Nämä kohdat kannattaa käydä läpi ennen kuin julkaiset säännöt.
- Estät kaiken. Jos haluat näkyä haussa, älä estä Googlebotia, Bingbotia etkä tekoälyhakua. Estä vain se, minkä haluat estää.
- Estät Googlebotin vahingossa. Tarkista, ettei tähtiryhmässä ole
Disallow: /ilman hakukoneiden omia sallivia ryhmiä. CDN:n luokkapohjaiset estot voivat tehdä saman huomaamatta. - robots.txt palauttaa HTML-sivun. Jos palvelin ohjaa osoitteen etusivulle tai virhesivulle, botti ei löydä sääntöjä. Tarkista sisältötyyppi ja statuskoodi.
- Luotat pelkkään käyttäjäagenttiin. Merkkijonon voi kirjoittaa kuka tahansa. Yhdistä se julkaistuun IP-avaruuteen tai käänteiseen nimipalveluun.
- Unohdat aliverkkotunnukset. robots.txt koskee vain sitä verkkotunnusta, jossa se on. Jos sisältöä on usealla aliverkkotunnuksella, jokainen tarvitsee oman tiedoston.
- Estät tiedostot, joita hakukone tarvitsee. Jos estät CSS- tai JavaScript-tiedostot, hakukone ei näe sivua oikein. Sama koskee kuvia, jos haluat ne kuvahakuun.
- Et tarkista lopputulosta. Avaa robots.txt selaimessa, aja
curl-komento ja katso lokista, mitä botit tekevät seuraavina päivinä. - Et kirjaa päätöstä. Merkitse muistiin päivämäärä, jolloin rajoitus tuli voimaan, ja säilytä kopio tiedostosta. Sillä on merkitystä, jos vetoat oikeuksien pidättämiseen.
Usein kysytyt kysymykset
Onko robots.txt pakottava?
Ei. Se on vapaaehtoinen käytäntö, jonka suuret toimijat ovat sitoutuneet huomioimaan. Cloudflare sanoo sen suoraan omassa ohjeessaan: tiedosto ilmaisee toiveen, mutta ei estä pääsyä teknisellä tasolla. Pakottava esto tehdään palomuurissa tai CDN:ssä.
Estääkö robots.txt GPTBotin varmasti?
Ei varmasti, mutta OpenAI kertoo noudattavansa sitä: GPTBotin estäminen merkitsee yhtiön mukaan, ettei sisältöä käytetä kielimallien opetukseen. Muutos voi näkyä viiveellä, ja vanha välimuistissa oleva sääntötiedosto voi olla voimassa jopa vuorokauden.
Kannattaako kaikki tekoälybotit estää?
Harvoin. Tekoälyhaku voi tuoda lukijoita ja näkyvyyttä, ja agentit voivat auttaa asiakasta käyttämään palveluasi. Useimmalle sivustolle järkevä linja on: haku sallitaan, koulutus estetään. Jos sisältö on maksullista tai helposti kopioitavaa, tiukempi linja on perusteltu.
Vaikuttaako esto Google-hakutuloksiin?
Google-Extendedin esto ei vaikuta. Googlebotin esto vaikuttaa suoraan: sivu poistuu hausta aikanaan. Myöskään CDN:n Training-luokan esto ei ole välttämättä turvallinen, koska Googlebot luokitellaan monikäyttöiseksi crawleriksi.
Riittääkö pelkkä Content-Signal-rivi?
Yksinään se ei estä mitään. Se on tarkoitettu oikeudelliseksi kannanotoksi ja teknisten järjestelmien tueksi. Yhdistä se robots.txt-sääntöihin ja tarvittaessa tekniseen estoon.
Voinko laskuttaa tekoälybotilta?
Voit, jos käytät alustaa, joka tukee maksullista kaavintaa. Cloudflaren Pay Per Crawl vastaa maksutta tulleeseen pyyntöön koodilla 402. Käytännössä tämä on julkaisijoiden ja alustojen välinen järjestely, ei yksittäisen pienen sivuston arkinen ratkaisu.
Mitä teen, jos botit eivät tottele?
Kiristä teknistä estoa: estä käyttäjäagentti ja varmennettu IP-avaruus CDN:ssä, rajoita pyyntöjen tahtia ja seuraa lokia. Jos kyse on selvästä tekijänoikeuden loukkauksesta tai henkilötietojen käsittelystä, ota yhteyttä lakimieheen. Säilytä lokit ja kopiot sääntötiedostosta.
Lähteet
- IETF: RFC 9309: Robots Exclusion Protocol, syyskuu 2022.
- OpenAI: Overview of OpenAI Crawlers, haettu 27.10.2026.
- Anthropic: Does Anthropic crawl data from the web, and how can site owners block the crawler?, 7.4.2026.
- Google: Google’s common crawlers, haettu 27.10.2026.
- Cloudflare: Your site, your rules: new AI traffic options for all customers, 15.7.2026.
- Cloudflare: robots.txt setting, päivitetty 22.10.2026.
- Cloudflare: Giving users choice with Cloudflare’s new Content Signals Policy, 15.7.2026.
- Cloudflare: Introducing pay per crawl.
- Euroopan unioni: Direktiivi (EU) 2019/790, 4 artikla.
- Tekijänoikeuden tiedotus- ja valvontakeskus: Tekijänoikeuden rajoitukset (tekijänoikeuslain 13 b §).
- llms-txt: The /llms.txt file, v2.
- Kuva: ChippyTimeCom, Blocked robots, according to website’s robots.txt as of June 2026, CC BY-SA 4.0, Wikimedia Commons.
Vastuuvapauslauseke: Tämä artikkeli on tarkoitettu vain tiedotustarkoituksiin. Sitä ei tarjota tai ole tarkoitettu käytettäväksi oikeudellisena, verotuksellisena, sijoitus-, rahoitus- tai muuna neuvona.
Mainos: alla on kumppanimainoksia ja mainoslinkkejä.